GPU-urile pierd 60% din putere în inferența AI
De ce recalcularea contextului consuma GPU-urile? Alan McSeveney, CTO de la WEKA, a dezvăluit în cadrul seriei VentureBeat AI Impact că GPU-urile care rulează modele mari de limbaj ar putea pierde…
De ce recalcularea contextului consuma GPU-urile?
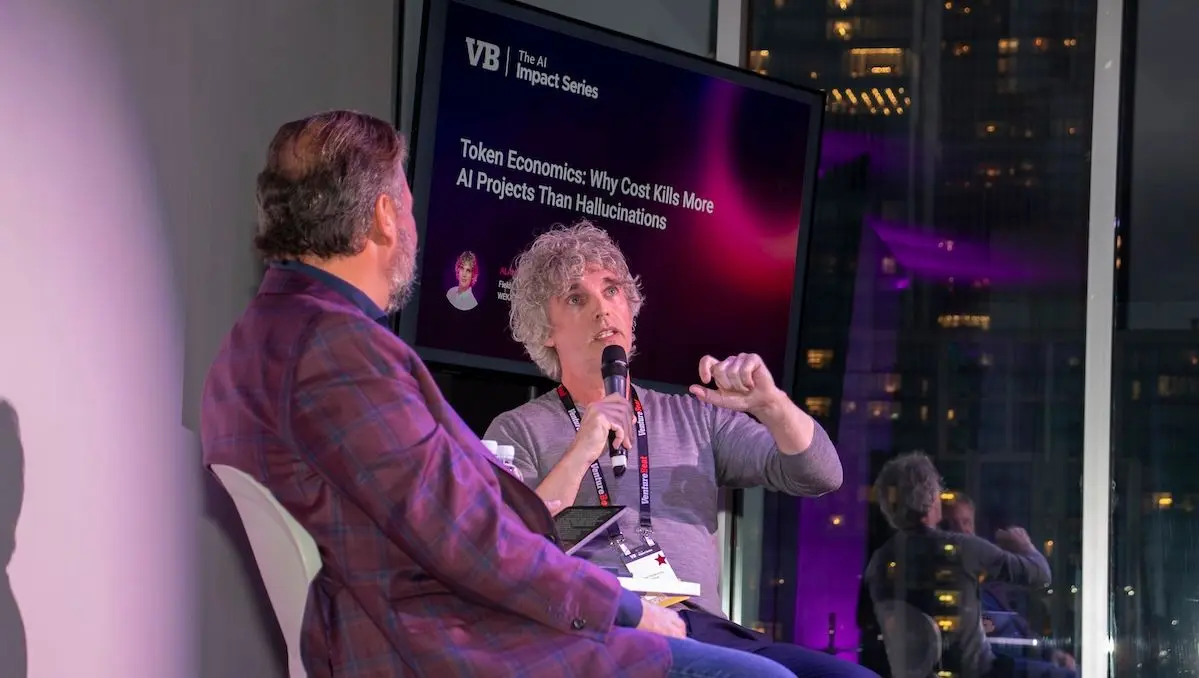
Alan McSeveney, CTO de la WEKA, a dezvăluit în cadrul seriei VentureBeat AI Impact că GPU-urile care rulează modele mari de limbaj ar putea pierde până la 60% din puterea lor de calcul, recalculând contextul deja procesat. Această descoperire a ieșit în discuția cu analistul principal Rob Strechay, evidențiind o ineficiență critică în infrastructura AI actuală, care limitează performanța modelelor și crește costurile operaționale.
Modelele mari de limbaj necesită acces continuu la tokenii precedenți pentru a menține coerența în timpul inferenței, dar arhitecturile existente obligă GPU-urile să reprocese acea informație în loc să o reutilizeze. McSeveney explică că această procesare redundantă apare deoarece modelele nu dispun de mecanisme eficiente de stocare și recuperare a stărilor intermediare, iar ciclurile de calcul se pierd pe sarcini repetitive.
Flash storage, subliniază el, ar putea remedia această problemă prin păstrarea contextului în afara GPU-ului, permițând astfel să se concentreze pe calcule noi.
Flash storage poate recupera puterea pierdută?
Prin transferul stocării contextului către sisteme flash rapide, GPU-urile ar putea redirecționa cele 60% de putere pierdute spre sarcini reale de inferență, sporind capacitatea utilizabilă fără a necesita hardware nou. McSeveney susține că integrarea flash storage în pipeline-ul AI ar reduce latența și consumul de energie, îmbunătățind în același timp throughput-ul. Această abordare transformă calculul inactiv în muncă productivă, abordând un blocaj fundamental în scalarea eficientă a implementărilor de modele mari.
Ce procent din calculul GPU-ului este pierdut pe recalcularea contextului în inferența LLM?
De ce GPU-urile pierd până la 60% din puterea de calcul?
Până la 60% din calculul GPU-ului este dedicat recalculării contextului deja procesat, potrivit lui Alan McSeveney de la WEKA.
Cum ajută flash storage la reducerea acestei ineficiențe în sarcinile AI?
Flash storage poate stoca contextul anterior extern, permițând GPU-urilor să evite calculele redundante și să reutilizeze acea putere pentru noi sarcini de inferență.
Sursă VentureBeat
Opinii
Nicio opinie încă. Scrie prima.
Mai multe din Digital
Waymo începe testele autonome în Toronto
Apple TV 4K: Prima reducere înainte de lansarea din noiembrie
India descoperă activități ale agenților AI neautorizate
Angajați care folosesc ChatGPT personal la birou: ce trebuie să facă administratorii IT
Apple oferă actualizare gratuită HomePod 2 cu trei noi funcții